
1. 基础概念
一个模型往往从下面两个维度上表现:
- 泛化能力:模型在训练数据上表现良好,更希望它能够在从未见过的新数据上保持较高的预测准确度
- 过拟合:模型在训练集上表现很好,但在测试集上表现很差
特别是在神经网络中,由于其极强的表达能力,更容易出现过拟合。
为了减少过拟合、提升泛化能力,人们设计了一系列策略来:
- 限制模型的复杂度
- 提高模型对噪声的鲁棒性
- 让模型更稳健
这些策略被称作正则化,使得模型在不同数据上保持良好的表现。
2. Dropout 正则化
2.1 公式定义
在神经网络中模型参数较多,在数据量不足的情况下,多个神经元相互依赖,形成只对训练集有效的复杂特征组合,很容易导致模型过拟合。
使用 Dropout 方法,在训练过程中,随机“失活”一部分神经元,迫使网络在不稳定结构下学习鲁棒、可复用的特征。
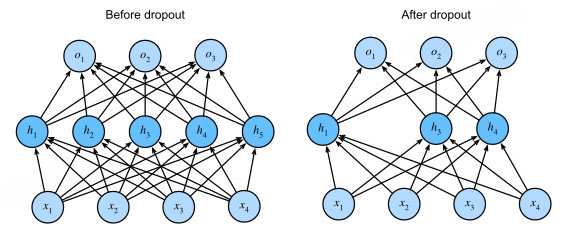
在训练阶段,对每一层(通常是全连接层):
对每个神经元独立采样一个伯努利随机变量:
\[r_i \sim \text{Bernoulli}(p) \]
神经元输出被随机屏蔽:
\[\tilde{h}_i = r_i \cdot h_i \]
其中:
- \(p\):保留概率(keep probability)
- \(1-p\):dropout rate
每一次 mini-batch 都对应一个不同的子网络结构。
在推理阶段,不再丢弃神经元,使用完整网络,并进行尺度补偿:
训练时:
\[\tilde{h}_i = \frac{r_i}{p} \cdot h_i \]
测试时:
\[\tilde{h}_i = h_i \]
2.2 计算示例
实验:
- 训练 不使用 Dropout 的模型
- 训练 使用 Dropout 的模型
- 记录训练 / 验证损失
python
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
import matplotlib.pyplot as plt

# 固定随机种子,保证实验可复现
torch.manual_seed(42)

# =========================================================
# 1. 构造一个小样本、带噪声的数据集(容易过拟合)
# =========================================================
def make_dataset(n_samples=200, input_dim=20):
    X = torch.randn(n_samples, input_dim)
    true_w = torch.randn(input_dim, 1)
    y = (X @ true_w + 0.5 * torch.randn(n_samples, 1) > 0).float()
    return X, y

X, y = make_dataset()

# 划分训练集 / 验证集
X_train, X_val = X[:150], X[150:]
y_train, y_val = y[:150], y[150:]

train_loader = DataLoader(
    TensorDataset(X_train, y_train),
    batch_size=32,
    shuffle=True
)

val_loader = DataLoader(
    TensorDataset(X_val, y_val),
    batch_size=32
)

# =========================================================
# 2. 定义 MLP 模型(是否使用 Dropout 作为参数)
# =========================================================
class MLP(nn.Module):
    def __init__(self, input_dim, use_dropout=False):
        super().__init__()

        self.net = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Dropout(p=0.5) if use_dropout else nn.Identity(),

            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Dropout(p=0.5) if use_dropout else nn.Identity(),

            nn.Linear(64, 1),
            nn.Sigmoid()
        )

    def forward(self, x):
        return self.net(x)

# =========================================================
# 3. 训练 / 验证函数
# =========================================================
def train_one_epoch(model, dataloader, optimizer, criterion):
    model.train()
    total_loss = 0.0

    for x, y in dataloader:
        optimizer.zero_grad()
        y_pred = model(x)
        loss = criterion(y_pred, y)
        loss.backward()
        optimizer.step()
        total_loss += loss.item()

    return total_loss / len(dataloader)


def evaluate(model, dataloader, criterion):
    model.eval()
    total_loss = 0.0

    with torch.no_grad():
        for x, y in dataloader:
            y_pred = model(x)
            loss = criterion(y_pred, y)
            total_loss += loss.item()

    return total_loss / len(dataloader)

# =========================================================
# 4. 运行实验(是否使用 Dropout)
# =========================================================
def run_experiment(use_dropout, num_epochs=50):
    model = MLP(input_dim=20, use_dropout=use_dropout)
    optimizer = optim.Adam(model.parameters(), lr=1e-3)
    criterion = nn.BCELoss()

    train_losses = []
    val_losses = []

    for epoch in range(num_epochs):
        train_loss = train_one_epoch(
            model, train_loader, optimizer, criterion
        )
        val_loss = evaluate(
            model, val_loader, criterion
        )

        train_losses.append(train_loss)
        val_losses.append(val_loss)

        print(
            f"[{'Dropout' if use_dropout else 'No Dropout'}] "
            f"Epoch {epoch:02d} | "
            f"Train Loss: {train_loss:.4f} | "
            f"Val Loss: {val_loss:.4f}"
        )

    return train_losses, val_losses

# =========================================================
# 5. 运行对比实验
# =========================================================
print("==== Training model WITHOUT Dropout ====")
train_no_dp, val_no_dp = run_experiment(use_dropout=False)

print("\n==== Training model WITH Dropout ====")
train_dp, val_dp = run_experiment(use_dropout=True)

# =========================================================
# 6. 可视化收敛曲线
# =========================================================
epochs = range(1, len(train_no_dp) + 1)

plt.figure(figsize=(10, 6))

# 无 Dropout
plt.plot(epochs, train_no_dp, '--', label="Train Loss (No Dropout)")
plt.plot(epochs, val_no_dp, '--', label="Val Loss (No Dropout)")

# 使用 Dropout
plt.plot(epochs, train_dp, label="Train Loss (Dropout)")
plt.plot(epochs, val_dp, label="Val Loss (Dropout)")

plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title("Dropout vs No Dropout: Training and Validation Loss")
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()3. 批量归一化
3.1 公式定义
在深度网络中,随着层数加深,每一层参数更新,会导致后续层输入分布不断变化,这被称为内部协变量偏移,这样会导致模型:
- 训练不稳定
- 对初始化和学习率敏感
- 收敛速度慢
而批量归一化(Batch Normalization)的核心目标是在每一层中,强制中间激活保持稳定分布。
设某一层的输入(线性变换后、激活前)为:
\[z = Wx + b \]
首先计算 mini-batch 的均值与方差:
\[\mu_B = \frac{1}{m} \sum_{i=1}^{m} z_i \]
\[\sigma_B^2 = \frac{1}{m} \sum_{i=1}^{m} (z_i - \mu_B)^2 \]
对每一层进行标准化:
\[\hat{z}_i = \frac{z_i - \mu_B}{\sqrt{\sigma_B^2 + \epsilon}} \]
其中 \(\epsilon\) 是一个很小的常数,防止分母为 \(0\)
然后执行仿射变换,对标准化的数据进行重构:
\[y_i = \gamma \hat{z}_i + \beta \]
其中:
- \(\gamma\):表示缩放参数
- \(\beta\):表示平移参数
3.2 计算示例
批量归一化主要分为三类:
- BatchNorm1d:主要用来处理一维数据,例如文本。输入数据的形状要求是(N条样本,num_features多个特征)
- BatchNorm2d:主要用来处理二维数据,例如图片。输入数据的形状要求是(N,C,H,W)。 N表示N张图片,C表示颜色通道,H图片的高度,W图片的宽度
- BatchNorm3d:主要处理三维数据,例如:视频、医学影像等。输入数据的形状要求是(N,C,D,H,W)
这里以一维批量归一化进行实验:
python
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
import matplotlib.pyplot as plt

torch.manual_seed(42)

# =====================================================
# 1. 构造数据(同样容易过拟合)
# =====================================================
def make_dataset(n_samples=300, input_dim=20):
    X = torch.randn(n_samples, input_dim)
    true_w = torch.randn(input_dim, 1)
    y = (X @ true_w + 0.8 * torch.randn(n_samples, 1) > 0).float()
    return X, y

X, y = make_dataset()

X_train, X_val = X[:200], X[200:]
y_train, y_val = y[:200], y[200:]

train_loader = DataLoader(
    TensorDataset(X_train, y_train),
    batch_size=32,
    shuffle=True
)

val_loader = DataLoader(
    TensorDataset(X_val, y_val),
    batch_size=32
)

# =====================================================
# 2. MLP 模型(是否使用 BatchNorm)
# =====================================================
class MLP(nn.Module):
    def __init__(self, input_dim, use_bn=False):
        super().__init__()

        self.net = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.BatchNorm1d(128) if use_bn else nn.Identity(),
            nn.ReLU(),

            nn.Linear(128, 64),
            nn.BatchNorm1d(64) if use_bn else nn.Identity(),
            nn.ReLU(),

            nn.Linear(64, 1),
            nn.Sigmoid()
        )

    def forward(self, x):
        return self.net(x)

# =====================================================
# 3. 训练 / 验证逻辑
# =====================================================
def train_one_epoch(model, loader, optimizer, criterion):
    model.train()
    total_loss = 0.0

    for x, y in loader:
        optimizer.zero_grad()
        y_pred = model(x)
        loss = criterion(y_pred, y)
        loss.backward()
        optimizer.step()
        total_loss += loss.item()

    return total_loss / len(loader)


def evaluate(model, loader, criterion):
    model.eval()
    total_loss = 0.0

    with torch.no_grad():
        for x, y in loader:
            y_pred = model(x)
            loss = criterion(y_pred, y)
            total_loss += loss.item()

    return total_loss / len(loader)

# =====================================================
# 4. 运行实验
# =====================================================
def run_experiment(use_bn, epochs=40):
    model = MLP(input_dim=20, use_bn=use_bn)
    optimizer = optim.Adam(model.parameters(), lr=1e-3)
    criterion = nn.BCELoss()

    train_losses, val_losses = [], []

    for epoch in range(epochs):
        train_loss = train_one_epoch(
            model, train_loader, optimizer, criterion
        )
        val_loss = evaluate(
            model, val_loader, criterion
        )

        train_losses.append(train_loss)
        val_losses.append(val_loss)

        print(
            f"[{'BatchNorm' if use_bn else 'No BN'}] "
            f"Epoch {epoch:02d} | "
            f"Train: {train_loss:.4f} | "
            f"Val: {val_loss:.4f}"
        )

    return train_losses, val_losses

# =====================================================
# 5. 对比运行
# =====================================================
print("==== Training WITHOUT Batch Normalization ====")
train_no_bn, val_no_bn = run_experiment(use_bn=False)

print("\n==== Training WITH Batch Normalization ====")
train_bn, val_bn = run_experiment(use_bn=True)

# =====================================================
# 6. 可视化
# =====================================================
epochs = range(1, len(train_bn) + 1)

plt.figure(figsize=(10, 6))

plt.plot(epochs, train_no_bn, '--', label="Train (No BN)")
plt.plot(epochs, val_no_bn, '--', label="Val (No BN)")

plt.plot(epochs, train_bn, label="Train (BN)")
plt.plot(epochs, val_bn, label="Val (BN)")

plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title("Batch Normalization vs No Normalization")
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()